Les agents d'IA vont vite. Ils écrivent du code, résument des dossiers, produisent des images. La question n'est plus de savoir s'ils savent faire. C'est de savoir si l'on peut se fier à ce qu'ils rendent, et à quel prix.
J'ai passé dix-sept ans dans l'ingénierie logicielle. Quand j'ai commencé à déléguer du développement à des agents, j'ai retrouvé les mêmes problèmes, encore et encore.
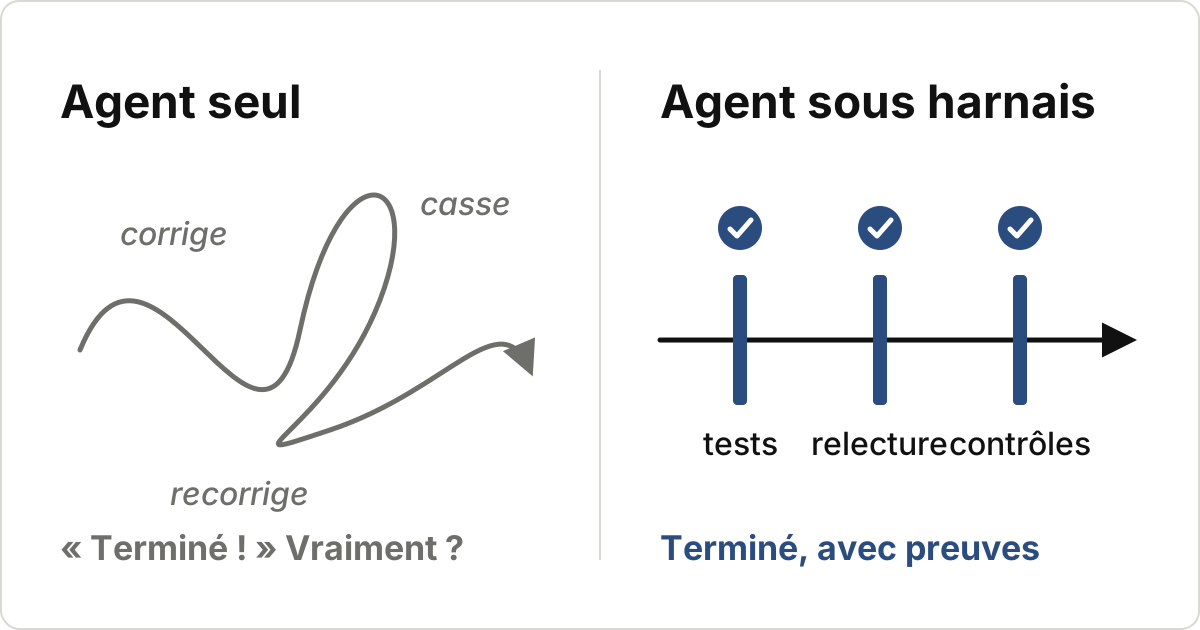
Ce qui casse quand on laisse l'agent seul
- « Tous les tests passent. » Sauf qu'ils ne testent rien : l'agent a écrit le code, puis des tests qui lui donnent raison.
- On demande une correction, on reçoit une refonte. Dix fichiers modifiés, une dépendance mise à jour, un « petit nettoyage » que personne n'a demandé.
- Relire coûte plus cher qu'écrire. Un énorme diff et un résumé confiant : vous êtes le seul filet de sécurité.
- Il tourne en rond, et chaque tour se paie. Corriger, casser, recorriger.
- Il oublie les règles en cours de route. Les consignes de la première heure s'effacent quand la session s'allonge.
Aucun de ces problèmes ne vient d'un manque d'intelligence du modèle. Ils viennent d'un manque de cadre.
Un workflow ne suffit pas, il faut un harnais
Un workflow dit dans quel ordre faire les choses. Un harnais empêche de sauter une étape. La différence est simple : dans un workflow, l'ordre est une consigne que l'agent peut oublier ; dans un harnais, il est écrit dans le code qui orchestre les agents.
C'est ce que j'ai construit pour mon propre métier avec Engineering Harness. Chaque tâche suit un chemin que l'agent ne peut pas raccourcir :
- Une spécification d'abord, découpée en petites étapes avec leurs critères d'acceptation. Le périmètre est écrit avant de toucher au code, et il ne s'élargit pas sans accord explicite.
- Les tests avant le code. Ils doivent échouer, et pour la bonne raison.
- Un autre agent relit ces tests avant qu'une seule ligne de code de production soit écrite.
- Le code, juste assez pour faire passer les tests.
- On casse le code exprès pour vérifier que les tests s'en aperçoivent.
- Un panel de relecteurs regarde ensuite le résultat sous plusieurs angles : le besoin, les tests, la dérive, les bugs, la sécurité quand il le faut.
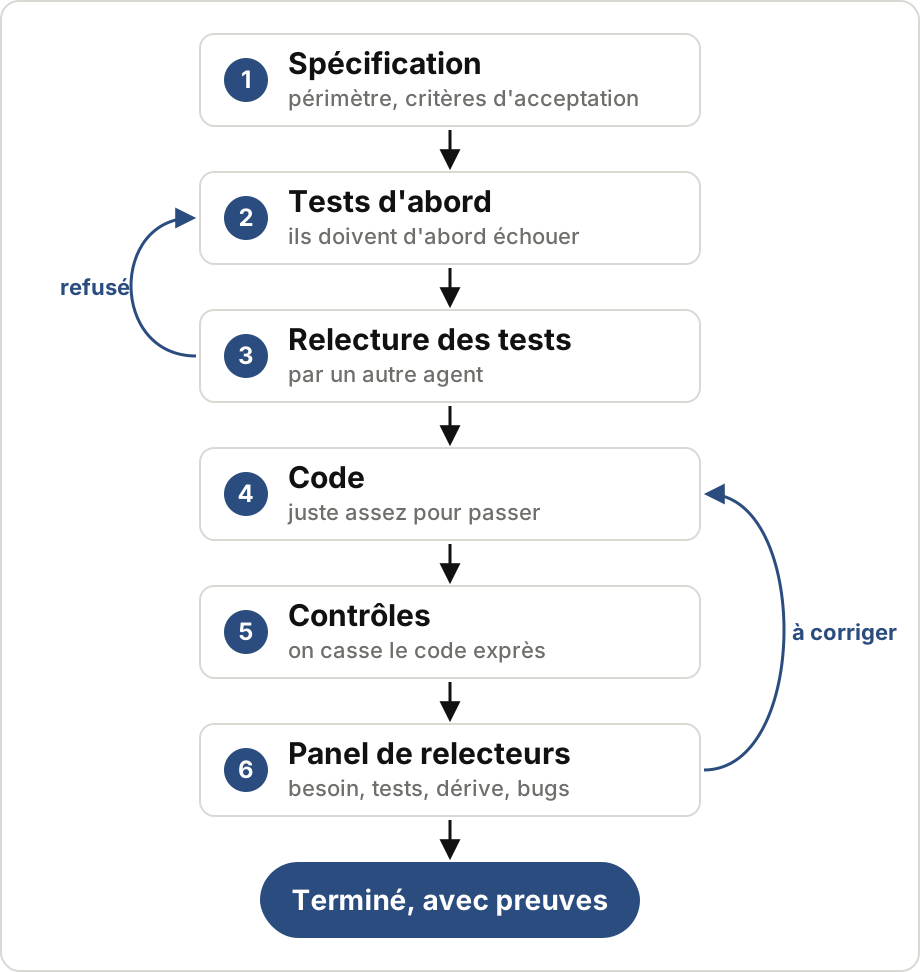
Chaque boucle a un budget. Quand il est épuisé, le flux s'arrête et me demande de décider, au lieu de tourner en rond à mes frais.
Savoir ce qui a été fait, et pourquoi
Un harnais ne sert pas qu'à empêcher les raccourcis. Il garde la trace de tout ce qui s'est passé. Quand on délègue un travail, c'est peut-être ce qui compte le plus : pouvoir revenir dessus.
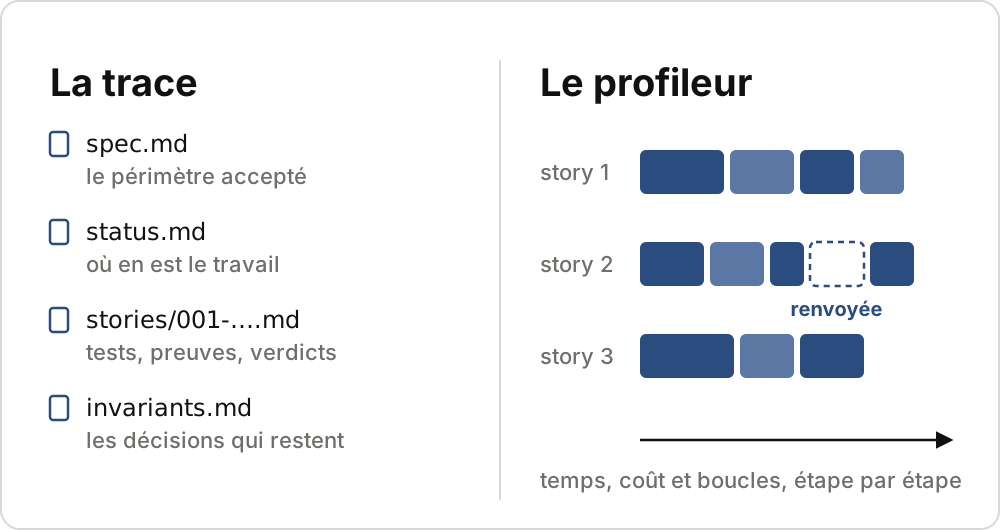
Chaque travail laisse un dossier dans le dépôt : la spécification acceptée, l'état d'avancement, et un fichier par story, c'est-à-dire par tâche, avec ses tests, ses preuves et les verdicts des relecteurs. Quand le travail se termine, les décisions qui doivent durer sont reportées dans les règles du projet, que les tâches suivantes doivent respecter. Des semaines plus tard, on retrouve ce qui a été fait, pourquoi, et sur quelles preuves. Et comme tout vit dans des fichiers plutôt que dans la mémoire d'une conversation, une nouvelle session reprend exactement là où la précédente s'est arrêtée.
L'observabilité est native. Un profileur reconstruit chaque exécution à partir de ce que le flux écrit déjà, sans demander un seul tour de plus aux agents. On y voit le chemin suivi, chaque boucle de chaque story, ce qui a été renvoyé, le temps passé et ce que chaque agent a coûté.
Les contrôles métier, ce n'est pas réservé aux développeurs
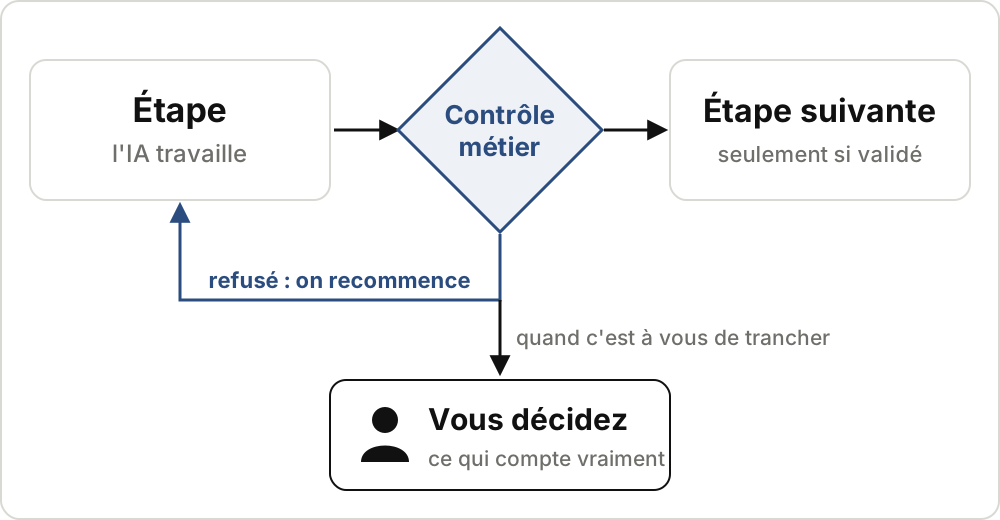
Le développement logiciel n'est qu'un métier parmi d'autres. Ce qui compte dans un harnais, ce ne sont pas les tests unitaires : ce sont les points de contrôle que le travail doit franchir avant d'avancer.
Pour n'importe quel métier, les mêmes questions reviennent :
- Qu'est-ce qui doit être vrai avant de passer à l'étape suivante ?
- Qui le vérifie : un autre agent, une règle, une personne ?
- Où l'IA doit-elle s'arrêter pour vous laisser décider ?
- Combien de tentatives lui accorde-t-on avant de vous rendre la main ?
- Quelle trace garde-t-on de ce qui a été fait, et pourquoi ?
J'ai fait ce travail une deuxième fois pour la création média, avec Hyoshigi : un logiciel qui encapsule tout un flux de création, d'une phrase au montage final. Le métier n'a rien à voir, la démarche est la même : comprendre comment le travail se fait vraiment, puis dessiner le harnais autour. C'est ce que je propose en quatre étapes, pour n'importe quel métier.
Ce qui reste à mesurer
Je ne vais pas vous vendre une fiabilité que je n'ai pas encore mesurée. Ajouter de la vérification rend le développement plus fiable, à mon sens, mais cela a un prix : un harnais fait plus d'étapes et plus de relectures qu'un agent laissé seul, donc il coûte plus de temps et de calcul.
La vraie question est de savoir quand cette fiabilité vaut son prix. C'est ce que mes prochains benchmarks doivent établir, et je publierai les résultats ici, y compris s'ils ne vont pas dans mon sens.
Si votre métier a besoin d'IA mais pas d'improvisation, parlons-en.